项目:Agent 评测看板
目标
从一份严格校验的虚构 JSON 快照生成四面板静态评测图:成功率及 Wilson 95% 区间、p50/p95 延迟与超时率、路由混淆矩阵、成本—成功率 Pareto 候选。课程交付一张从仓库数据与脚本实际生成的 PNG,并保留可重复导出 SVG 和文字替代说明的命令;自动测试与实际读图共同验收。
这不是实时 BI 系统,也不证明某个真实 Agent 的表现。练习重点是让每个数字有分母、每种误差有语义、每个颜色编码有冗余线索,并暴露质量—延迟—成本之间的冲突。
文件与输入契约
- agent_eval_dashboard.py:严格读取、计算、绘图与导出的主脚本。
- sample_agent_eval.json:包含数据版本、三版聚合指标与路由矩阵的虚构快照;不含真实用户数据。
- test_agent_eval_dashboard.py:覆盖输入拒绝、Wilson 区间、Pareto、图结构、PNG/SVG/替代文本与 CLI。
- requirements.txt:固定本轮验证的直接依赖
matplotlib==3.11.0;它不是传递依赖 lockfile。 - agent-eval-dashboard.png:从上述 fixture 生成并经人工读图检查的课程图。
- agent-eval-dashboard-alt.txt:由同一数据生成的机器可重建文字替代说明。
脚本只接受 2~5 个版本,避免图例和标签过载。每版必须有唯一名称、成功数、任务数、超时数、p50/p95、平均成本;要求 success + timeout ≤ task_count、至少有一个完成运行(否则 p50/p95 没有定义)、p95 ≥ p50、成本非负。路由标签必须唯一,矩阵必须方阵、每行非空,且矩阵总数等于指定版本的任务数。未知字段、重复 JSON key、NaN/Infinity、负计数和不一致总数都会被拒绝。
Windows 11 与 PowerShell 7 运行
从本项目根目录执行。虚拟环境、Matplotlib 配置/字体缓存和全部试运行输出都放在系统临时目录,不在 vault 内创建 .venv、缓存或覆盖课程工件:
$examples = (Resolve-Path '.\docs\数据可视化\examples').Path
$practice = Join-Path $env:TEMP ("ai-agent-viz-{0}" -f [guid]::NewGuid())
$venv = Join-Path $practice 'venv'
$mplConfig = Join-Path $practice 'mplconfig'
$outputDir = Join-Path $practice 'output'

py -3.11 -m venv $venv
$python = Join-Path $venv 'Scripts\python.exe'
& $python -m pip install --upgrade pip
& $python -m pip install -r (Join-Path $examples 'requirements.txt')
& $python -m pip check
New-Item -ItemType Directory -Path $mplConfig, $outputDir -Force | Out-Null

$env:MPLCONFIGDIR = $mplConfig
$env:MPLBACKEND = 'Agg'
& $python -B (Join-Path $examples 'agent_eval_dashboard.py') `
  --data (Join-Path $examples 'sample_agent_eval.json') `
  --output (Join-Path $outputDir 'agent-eval-dashboard.png') `
  --output (Join-Path $outputDir 'agent-eval.svg') `
  --alt-output (Join-Path $outputDir 'agent-eval-dashboard-alt.txt')

& $python -B -m unittest discover -s $examples -p 'test_agent_eval_dashboard.py' -v
& $python -B -O -m unittest discover -s $examples -p 'test_agent_eval_dashboard.py' -v
$env:PYTHONWARNINGS = 'error'
try {
  & $python -B -m unittest discover -s $examples -p 'test_agent_eval_dashboard.py' -v
  & $python -B -O -m unittest discover -s $examples -p 'test_agent_eval_dashboard.py' -v
} finally {
  Remove-Item Env:PYTHONWARNINGS -ErrorAction SilentlyContinue
}
脚本显式使用非交互 Agg backend。PNG 默认 300 DPI,并固定为 11×7.4 英寸(3300×2220 px);测试断言精确像素,避免 tight bounding box 悄悄改变最终尺寸。SVG 保留线条与文字的矢量结构,JPEG 被主动拒绝。若用于论文或出版物,仍应按目标期刊的最终尺寸、字体和格式要求重新配置,而不是直接提交教学看板。
实际生成结果
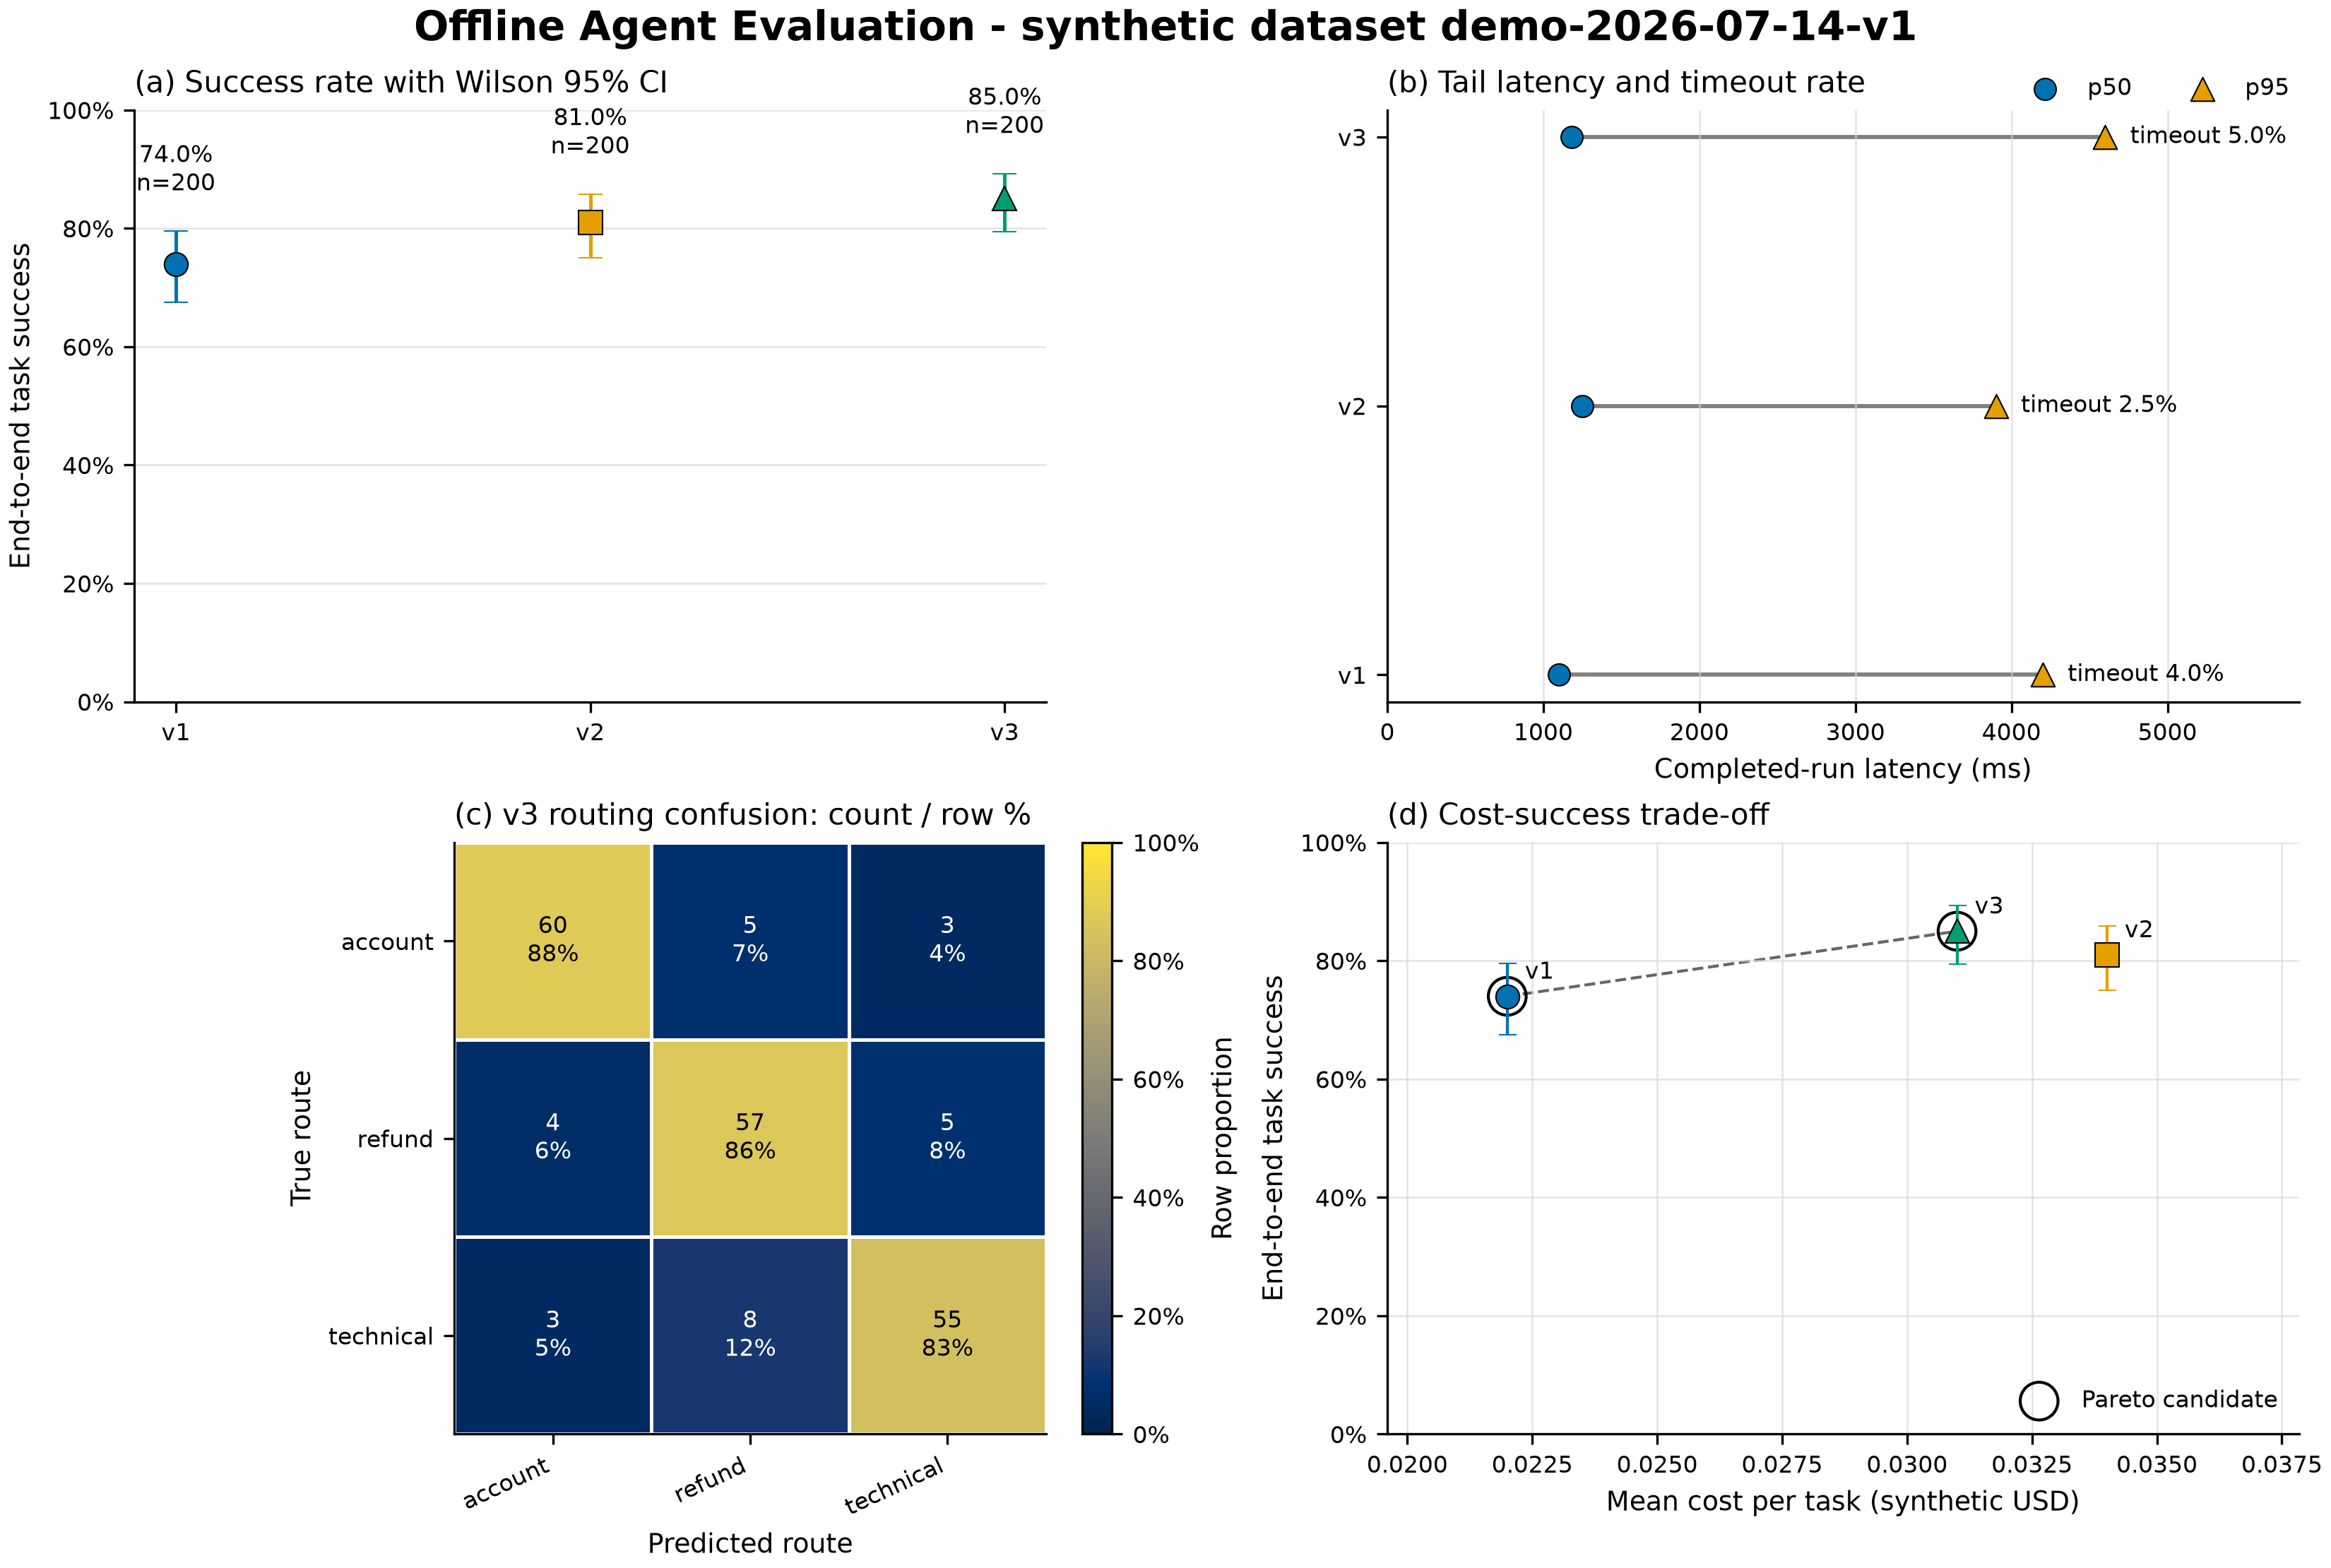
图 1 离线 Agent 评测看板,数据版本 demo-2026-07-14-v1,于 2026-07-18 使用 Python 3.11.9、Matplotlib 3.11.0 和本页命令重新生成。数据来源为仓库内虚构聚合 fixture,不含真实用户或供应商结果;图与数据为本项目原创教学产物,仓库未声明统一再分发许可证,外部再利用前需由维护者确认。再生成入口为 examples/agent_eval_dashboard.py,生成参数和依赖已在上文固定。
**文字替代:**四个面板比较 v1、v2、v3。成功率分别为 74%、81%、85%,并显示 Wilson 95% 区间;v3 成功率最高,同时 p95 延迟 4600 ms、超时率 5% 也最高。v3 路由矩阵最大非对角错误为 8 个 technical 被判成 refund。只按平均成本越低、成功率越高定义,v1 与 v3 是 Pareto 候选,v2 被 v3 支配。由脚本生成的完整英文替代文本见 agent-eval-dashboard-alt.txt。
预期读图结果
样例固定 3 个版本、每版 200 道任务:
- v1/v2/v3 成功率分别为 74.0%、81.0%、85.0%;区间采用 Wilson 95% CI,不使用边界不稳的对称正态近似。
- v3 成功率最高,但完成运行 p95 为 4600 ms、超时率 5.0%,二者也是三版中最高;不能只凭成功率宣布全面胜出。
- v3 路由矩阵共 200 条,格子同时给绝对数与行百分比;最大非对角冲突是
technical → refund的 8 条。 - 在“成本越低、成功率越高”的二维定义下,v1 与 v3 是 Pareto 候选;v2 被 v3 以更低成本和更高成功率支配。这不等于已考虑安全或尾延迟门槛。
命令行摘要应包含:
dataset=demo-2026-07-14-v1 rates=[v1=74.0%, v2=81.0%, v3=85.0%] pareto=v1,v3视觉自检闭环
- 打开临时目录的 PNG,在 100% 大小核对四个面板、标题、轴标签、图例、色条和格子文字是否完整。
- 检查 (a) 的误差棒没有被上界裁切;(b) 的
p50圆点与p95三角在灰度下仍能区分;(c) 的深浅格子文字都可读;(d) 的 Pareto 空心圈没有遮住版本 marker。 - 确认无中文缺字 warning、刻度碰撞、图例压数据、子图标题错位或画布裁切。
- 将图片转为灰度或在系统预览中降低饱和度,确认结论不依赖蓝/橙/绿本身。
- 对照
agent-eval.txt:文字必须来自同一数据快照,报告主要权衡和最大冲突,而不是描述装饰。
自动测试只能证明结构、文件签名、尺寸和数据计算满足契约,不能替代第 1~5 步的感知检查。
本轮验证
2026-07-14 在 vault 外的临时 venv 中使用 Python 3.11.9、Matplotlib 3.11.0 完成首轮验证;2026-07-18 按同一固定直接依赖重新生成课程 PNG 和文字替代说明;2026-07-20 再次用隔离环境复验:
py_compile通过;12 项unittest在普通与-O模式均通过,且设置PYTHONWARNINGS=error。- CLI 从样例 JSON 生成 PNG、SVG 与替代文本;摘要、成功率和 Pareto 集与手算一致。
- 移除会改变画布尺寸的
bbox_inches="tight"后,格式审计确认 PNG 精确为 3300×2220、300 DPI;SVG 无嵌入位图。 - 第一轮实际读图发现 (b) 面板图例遮住 v1 数据;将图例移到坐标区上方后重新渲染。第二轮彩色与 RGB 灰度预览均未见图例遮挡、文字重叠、误差棒越界或格子文字失去对比。
- 2026-07-18 的 12 项测试在普通与
-O模式、warnings-as-errors 下各运行一次并全部通过;人工检查实际 PNG 未见裁切、遮挡、重叠或低对比文字。 - 2026-07-20 在 Python 3.11.9、Matplotlib 3.11.0(本次解析到 NumPy 2.4.6、Pillow 12.3.0)的 vault 外环境中,12 项测试在 normal、
-O、-W error与-O -W error四模式各通过一次;这组传递依赖版本是复验快照,不是完整锁文件。 - 测试和绘图不在知识库生成
__pycache__;依赖环境、Matplotlib 配置缓存和临时 SVG 位于系统临时目录。vault 只保留经过核验的 PNG、fixture、脚本和文字替代说明。
扩展任务
- 把某版
task_count改为 20,并保持计数一致,观察 Wilson 区间如何变宽。 - 给样例增加一个合法第四版本,判断它是否进入 Pareto 集;不得超过 5 个版本。
- 在不改变总任务数的前提下加入第四个路由类别,更新标签与 4×4 矩阵。
- 从逐任务数据自行聚合 p50/p95 与超时率,并保存生成聚合快照的脚本;不要手改图中数字。
- 为安全失败建立独立面板或报告,不能用总体成功率稀释严重事件。
- 写一段 150 字发布建议,同时报告改善、退化、不确定性、评测边界和下一步验证。
验收标准
- 严格输入能运行,损坏/歧义输入会以清晰错误拒绝。
- 普通与
-O模式测试全部通过,warning 被视为失败。 - PNG、临时 SVG 与替代文本都从同一快照生成;vault 只保留经过核验且有来源/许可边界的课程 PNG 与替代说明。
- 能手算样例成功率,并解释 Wilson 区间和普通正态近似的差别。
- 能指出 v3 的质量改善与尾延迟/超时退化,不用单一总分掩盖权衡。
- 实际阅读 PNG 和灰度效果,确认文字、布局和冗余编码可用。
自测
- 为什么 (a) 使用点和区间,而不是从零起的均值柱?
- 成功率的 95% 区间是否表示“真实成功率有 95% 概率落在本次区间”?
- 路由矩阵按行百分比与绝对数分别回答什么?
- v3 支配 v2 为什么仍不足以决定发布?
technical → refund的 8 条冲突应怎样回到逐任务样本排查?- 生成 SVG 和替代文本分别解决了什么可访问性/可复现问题?
完成后返回数据可视化目录,并把数据快照、命令、依赖版本、图片检查结果一起记录,而不是只保存最终 PNG。
参考资料
资料核验日期:2026-07-20;示例固定直接依赖 Matplotlib 3.11.0,传递依赖仍由安装时解析。