2026-07-18 内容审计与重构记录
结论摘要
本轮结论不是“原有 53 门课全部重写”。基线检查表明,现代主线课程的首页、来源边界、实践项目和掌握标准整体已经较成熟;主要问题是:总路线把全部课程呈现为单一线性序列,核心能力仍有三处明确缺口,图示与真实运行结果集中在参考层而未进入主线,网站又把 53 门课、8 个阶段和连续整数顺序写死。
因此采取以下策略:
- 保留原 53 个课程入口,不做无证据删除或批量改写;
- 新增“现代 LLM 能力与模型选择”“环境型 Agent”“实时多模态交互”3 门课程,补齐明确缺口;
- 将总路线改为课程地图、角色路径和内容层级,不再要求人人线性完成全部课程;
- 对 Agent、RAG、评测、安全、多 Agent、LLMOps 等高价值主线做精确补图,对数据可视化项目实际生成并嵌入结果;
- 更新 MCP、Agent Skills、A2A/AG-UI 的稳定、扩展、实验和观察边界;
- 将尚未完成来源核验的机器学习速查页明确降级,不借“全库优化”名义重写全部历史镜像;
- 将网站课程发现、阶段统计和导航改为由元数据动态生成,为后续增删课消除硬编码阻碍。
决策边界
“保留”不等于证明每一段历史内容都准确;“降级为参考”也不等于内容毫无价值。本轮只对有足够证据且影响主线的内容直接修改。未经逐页核验的镜像、法律结论、第三方图片许可和快速变化协议不会被写成稳定事实。
审计范围与基线
基线是本轮修改前的 docs/ 与既有网站生成清单,不包含本轮新增课程。计数回答“有什么”,不能单独证明“质量怎样”。
| 项目 | 基线 | 口径与解释 |
|---|---|---|
| 顶层课程入口 | 53 | docs/<课程>/00-目录.md;53 个入口均有 ai_learning_stage、ai_learning_order、学习目标、前置和掌握标准 |
| Markdown | 844 | 包括原创主线、框架/官方资料整理和历史完整教程;不是 844 篇同等优先级课程 |
| Python | 172 | 代码存在量,不代表均已被测试或适合生产 |
文件名含 test 的 Python | 61 | 其中 57 个采用 test_*.py,另有 4 个位于 Python 历史材料;这是命名计数,不是独立测试套件数 |
主线教学范围的 examples/ 目录 | 49 | 原始物理扫描为 51;审计口径排除 Agentic Design Patterns 与 LangChain 两个冻结/导入参考子树中的 examples/ |
| 图片资产 | 534 | 501 PNG、29 JPG、1 JPEG、1 GIF、2 WebP |
| 含 Mermaid 的 Markdown | 15 | 6 篇 LangChain、6 篇 Markdown、1 篇工作流自动化、2 篇机器学习;Agent/RAG/评测/安全/多 Agent/LLMOps 主线当时均无 Mermaid |
| 顶层索引 wikilink | 0 个未解析 | 只证明课程首页显式 wikilink 存在,不等于全库相对链接无误 |
| 课程分类元数据 | 0/53 有统一 content_tier/difficulty;3/53 明示投入时间 | 说明路线具备顺序,但缺少角色选择和层级表达;不能用机械批量回填解决 |
图片分布揭示的问题比总量更重要:Python 基础有 462 个、Agentic Design Patterns 有 60 个、LangChain 有 12 个,三者合计正好 534 个。也就是说,基线图片全部集中在历史教程或框架参考层,主线的 runtime、数据流、信任边界和发布状态机没有获得相称的视觉解释。
既有网站生成清单与 844 篇源 Markdown 对齐:687 篇全文、157 篇 stub、3 个生成页,共 847 个 staged 页面;187 个资源进入公开层,650 个资源被规则排除,未见 route collision。该清单是审计起点的静态证据,不替代本轮修改后的最终构建。
证据层级
本轮按以下优先级作判断:
- 当前仓库事实:文件、frontmatter、索引、脚本、fixtures、测试、生成清单和发布规则;
- 标准与第一方资料:MCP、Agent Skills、JSON Schema、W3C、IETF、NIST、OWASP、MITRE、Playwright 等官方规范或文档;
- 原始论文与官方项目:HELM、Model Cards、WebArena、OSWorld、SWE-bench、RAG、MTEB 等;
- 供应商动态文档:只用于核对当日 API、模型目录、版本与实现样例,不上升为供应商无关结论;
- 既有整理与工程推断:作为定位线索;无法被更高层证据确认时,标为观察、实验、待核验或未知。
对易变化内容采用四类状态:
| 状态 | 含义 | 处理方式 |
|---|---|---|
| stable | 已发布规范、长期工程不变量 | 可进入核心掌握标准,但仍记录版本与日期 |
| dynamic | 模型目录、SDK、价格、配额、区域和产品 API | 只保留核验入口与选择方法,接入当日重查 |
| frontier/observed | 草案、实验扩展、新协议或近期预印本 | 独立专题或观察表,不作为稳定前置 |
| needs-review | 历史页尚未逐项核对来源、公式或实现 | 从主线降级并加警告,不继续传播为默认做法 |
抽样与限制
- 全量完成了目录、课程首页、元数据、文件类型、示例/测试命名、Mermaid/图片分布和公开规则检查;没有逐句事实核验 844 篇 Markdown。
- 深读优先覆盖 Agent 核心、Tool Calling、MCP、Agent Skills、RAG、评测、LLMOps、运行监控、安全、治理、多 Agent、数据可视化和机器学习入口;参考镜像按风险抽样。
- “有参考资料标题”只是结构证据。部分课程使用“下一步与参考”等不同标题,不能因关键词统计缺失就判定无来源。
- 公开 benchmark、论文实验和供应商说明只能帮助发现候选与失败模式,不能证明本地业务、权限、语言、成本和延迟条件。
- 测试文件数不能证明覆盖率;离线模拟器也不能证明真实浏览器、桌面、音频栈、云服务或模型行为。
- 法规、跨境数据、录音同意、许可证和第三方再分发需要相应负责人判断,本轮不提供法律结论。
- Python 冻结参考层的相对链接抽查仍发现约 103 个历史断链和 3 个 stub 过渡问题;它们不阻断原创主线,但若继续公开该层,需要单独修复或归档决策。
原 53 门课程的分层与处理判断
下表中的“合并导航”表示在角色路径中归组,不表示物理合并文件。独立课程拥有不同数据契约、测试、来源与失败定位职责,仓促合并会降低可维护性并破坏链接。
核心课程
| 原课程 | 判断 | 依据与后续边界 |
|---|---|---|
| AI基础认知 | 保留 | 提供问题、数据、模型、评测和责任使用的共同语言;不再要求先读完整历史基础层 |
| AI安全 | 精确更新后保留 | 已有 OWASP/NIST/MITRE 主线;本轮补信任边界图,后续按权威版本滚动复核 |
| Agent Skills | 更新后保留 | 明确开放格式与具体 client 的边界、必填/可选字段及 allowed-tools 实验状态 |
| Agent 核心 | 精确更新后保留 | model proposal 与确定性 runtime、状态、恢复、HITL、不可信 observation 已形成完整主线;补控制闭环图 |
| JSON | 保留为契约前置 | schema、严格解析和结构化输出是工具、协议和评测的共同基础;熟练者可直接跳过 |
| LLM API集成 | 保留 | provider adapter、timeout、usage、重试和版本固定仍是核心;动态产品参数必须当日核验 |
| LLMOps | 精确更新后保留 | 与评测门、灰度、回滚和 release manifest 相连;本轮补发布门禁状态机 |
| MCP | 更新后保留 | 稳定 core、扩展、实验 Tasks、Apps 与 Draft 已分层;不把 MCP 当 planner 或授权证明 |
| RAG | 精确更新后保留 | 双管线、ACL、引用、更新、分层评测与排错主线完整;补三平面图和失败回溯树 |
| Tool Calling | 保留 | schema、调度、授权、幂等和错误语义是 Agent runtime 的直接前置;不退化为产品 API 手册 |
| 上下文工程 | 保留 | 状态、证据选择、预算、压缩和失效是长任务的横向能力;与“上下文窗口”参数分开 |
| 提示词工程 | 保留 | 作为可测试输入合同,不作为权限或安全控制;熟练者可通过掌握标准跳课 |
| 概率统计 | 保留为横向前置 | 多 trial、区间、切片和线上实验需要;主线只要求真实用到的统计,不强制完整数学路线 |
| 评测体系 | 精确更新后保留 | task/trial/trace/grader/outcome/harness 已统一;本轮补对象关系图,继续作为发布证据中心 |
| 运行监控 | 保留 | 负责线上 SLO、trace、成本、异常和事故信号;不能用监控替代冻结评测 |
| 隐私计算 | 保留 | 数据最小化、访问、部署和审计是模型/RAG/Agent 的硬门槛;具体法规交由有权限负责人复核 |
角色进阶课程
| 原课程 | 判断 | 依据与后续边界 |
|---|---|---|
| AI治理 | 保留,定期更新 | 系统清单、风险分级、证据和变更治理有长期价值;地区法规只记录核验日期与适用范围 |
| Benchmark设计 | 保留并接入可靠性路径 | 负责长期可比任务协议,与面向具体产品决策的评测体系分工,不物理合并 |
| Chunking策略 | 合并到 RAG 导航 | 独立保留切分边界、结构、版本和失败测试;不再作为所有学习者的线性前置 |
| Embedding | 合并到 RAG 导航 | 按私有检索任务、语言、领域、维度和迁移成本评测,不使用通用榜单替代 |
| MLOps | 保留为平台桥接 | 训练/数据/模型生命周期对自托管和分类器仍重要;一般 Agent 应用可按需学习 |
| OCR | 合并到多模态导航 | 作为文档感知层,需与版面、引用和下游任务分层评测;不与通用多模态课重复讲产品调用 |
| Reranking | 合并到 RAG 导航 | 保留候选集、排序指标、延迟和故障定位边界 |
| 向量基础 | 合并导航,按需前置 | 支撑 embedding 与相似度直觉;熟练者不必线性重学 |
| 向量数据库 | 合并到 RAG 导航 | 保留索引、过滤、更新、租户和运维边界;具体产品只作为案例 |
| 多Agent协作 | 更新后保留 | 强调拓扑、所有权、消息、冲突、共享资源和整体评测;A2A 与 AG-UI 分别记录稳定/观察状态 |
| 多模态AI | 保留为多模态总入口 | 串联图像、文档、音频、视频和端到端评测;与新增实时课程形成角色路径 |
| 工作流自动化 | 保留 | DAG、调度、队列、补偿和 durable execution 是生产 Agent 的确定性底座 |
| 数据可视化 | 精确更新后保留 | 已从“展示绘图代码”提升为实际嵌入、可再生成、带替代说明的评测证据项目 |
| 数据合成 | 保留 | 用于困难/稀有/对抗 case,但必须标记合成来源并用真实数据验证效用 |
| 数据标注 | 合并到数据/RAG 导航 | 标签契约、分歧和质量控制独立于具体模型,保留为角色课 |
| 数据清洗 | 合并到数据/RAG 导航 | 单位、缺失、重复、泄漏和版本问题会直接污染检索与评测,不应删除 |
| 文档解析 | 合并到 RAG 导航 | 负责版面、结构、表格、附件和 provenance;与 chunking 分层定位失败 |
| 知识库构建 | 合并到 RAG 导航 | 承担来源登记、ACL、revision、更新和删除,不与“向量库”混为一课 |
| 语义搜索 | 合并到 RAG 导航 | 保留 query/corpus/relevance 和检索评测闭环 |
| 语音合成 | 合并到多模态/实时导航 | 作为输出通道保留质量、延迟、安全和许可边界 |
| 语音识别 | 合并到多模态/实时导航 | 作为输入通道保留噪声、口音、partial/final、时间戳和分层错误分析 |
前沿专题入口
| 原课程 | 判断 | 依据与后续边界 |
|---|---|---|
| 图像生成 | 保留为可选前沿/专项 | 只有项目确需生成视觉资产时学习;模型、限制和许可均为动态事实 |
| 视频生成 | 保留为可选前沿/专项 | 不作为 Agent 主线前置;重点保留任务合同、异步作业、审核和成本边界 |
实践、前置与参考层
| 原课程 | 判断 | 依据与后续边界 |
|---|---|---|
| API | 保留为工程前置 | HTTP、认证、分页、限流、重试和幂等仍是工具与协议底座;按能力缺口学习 |
| Agentic Design Patterns | 降级为模式参考 | 大体积导入/翻译层有查询价值,但不承担稳定主线;以 Agent 核心和工作流课的契约为准 |
| CrewAI | 保留为框架案例 | 用于观察一种实现,不把框架抽象当供应商无关原理 |
| Git | 保留为工程前置 | 编码 Agent、实验版本和回滚需要;熟练者可跳过 |
| LangChain | 降级为框架/官方资料参考 | 内容体积和既有图示较多,但易随版本变化;主线不依赖其 API |
| Linux命令 | 保留为按需前置 | 云端、容器和沙箱操作仍有价值;Windows 主环境不强制线性完成 |
| Markdown | 保留为知识产物前置 | 文档、引用、Mermaid、Obsidian 与公开站点都依赖可读源文件 |
| Python基础 | 双层保留、历史层降级 | Agent 工程短路线作为前置;100 天完整教程保留为历史参考,不要求主线学习,也不批量修旧链 |
| 微积分基础 | 降级为按需参考 | 对一般 Agent 应用不是硬前置;研究训练、优化或论文公式时再进入 |
| 数据结构基础 | 保留为工程前置 | 队列、栈、图、缓存和调度直接支撑 runtime;以可运行小项目为完成证据 |
| 机器学习 | 保留短主线,弱页降级 | 分类、泄漏、Pipeline、指标和误差分析仍有用;未经核验的 loss/optimizer 历史速查不计入掌握标准 |
| 正则表达式 | 保留为工具型参考 | 解析、清洗与验证常用,但不作为所有角色的完整课程要求 |
| 深度学习 | 降级为历史/研究参考 | 完整教程对模型研究有价值,一般 Agent 工程只按 embedding、推理与多模态需求取用 |
| 线性代数 | 保留为按需参考 | 向量、相似度和 embedding 需要核心直觉,不要求完成与主线无关的全部推导 |
为什么本轮没有删除或物理合并课程
删除判断为 0 门,物理合并判断为 0 门。理由不是保守地拒绝改变,而是当前证据支持“降低导航优先级”多于“内容没有保留价值”:
- 历史完整教程仍可用于补基础、研究或离线查阅;主线问题来自入口权重,不仅是文件存在。
- 框架/官方资料镜像易过时,但其中的术语、迁移线索和案例仍有参考价值;公开站点已经使用 stub/发布策略限制大体积层。
- 物理删除或改名会破坏 wikilink、相对链接、附件和外部书签;在未完成使用量、许可、替代页和重定向审计前,收益不足以覆盖风险。
- RAG 子课、数据课和多模态子课有不同输入契约、测试与失败责任层;合成一篇“大而全”页面反而降低教学和排障效果。
- 用户明确要求避免批量替换和无差别重写。对高质量主线保持原文、只补缺口,符合证据边界。
后续若决定删除,至少先满足:有替代入口、反向链接已清点、公开 URL 有重定向、第三方资产许可已判断、用户确认不再需要历史层,并在独立变更中执行。
本轮已落实的结构与内容变更
非线性总路线
AI Agent Engineer 学习路线 现在包含:
- 按现有能力选择入口,而不是从第 1 门线性读到最后;
- Agent 应用开发、RAG 与知识库、Agent 平台与可靠性、多模态与实时交互 4 条角色路径;
- 核心、进阶、前沿、实践、参考 5 类内容层级;
- 以架构/结构说明、可运行实现、预期失败、验证命令和“不适用边界”组成学习闭环;
- 保留唯一主课程 Dataview 地图,公开导出时由网站脚本精确替换,不误伤其他 Dataview 块。
新增 3 门课程
| 新课程 | 层级与位置 | 补齐的缺口 | 实践证据 |
|---|---|---|---|
| 现代 LLM 能力与模型选择 | core;LLM 应用基础 | 推理、有效上下文、结构化输出、tool support、多模态、embedding、成本/延迟/隐私/部署;不维护排行榜 | 严格 JSON、硬门槛优先、合格集评分、Pareto 与权重敏感性;相邻 20 项测试 |
| 环境型 Agent | advanced;单 Agent 与工具 | 浏览器、桌面、编码 Agent 的 observation–action contract、沙箱、审批、回滚、恢复与环境终态评测 | 标准库内存环境 runtime;模型外 HMAC 审批与 needs_review 对账;相邻 103 项测试 |
| 实时多模态交互 | advanced;扩展应用 | 级联与 speech-to-speech、WebRTC/WebSocket/SIP、VAD、barge-in、工具、状态、背压、断线恢复和端到端评测 | 严格事件/会话模拟器;相邻 24 项测试 |
测试项数量描述随课程交付的局部套件规模,不在此冒充最终全库验证;最终验证见文末“最终验证”区。
MCP、Skills 与协议版图
- MCP 已把
2025-11-25stable core 与 Draft 分开;补充动态工具发现和 host 按需选择的分层、扩展协商、Apps 信任边界,以及 legacy Tasks 与新 Tasks extension 的 wire 不兼容风险。 - MCP 扩展、Apps 与版本兼容 被标为
frontier/observed,不成为稳定前置。 - Agent Skills 已复核必填
name/description、可选字段与实验性allowed-tools,并把官方资料整理层与原创学习路线分开。 - 多 Agent 协议版图 区分 MCP(Agent—能力)、A2A(Agent—Agent)和 AG-UI(Agent—用户界面);AG-UI 只进入观察列表,不以项目方 integrations 声明替代独立采用证据。
关键 Mermaid
基线 15 个 Mermaid 文件主要位于 Markdown 与 LangChain 参考层。本轮把图放到关系复杂、单靠段落不易理解的主线位置,并在图后写图注、文字替代、来源边界和“源码即再生成方式”:
- 模型 proposal—runtime—工具—verifier 控制闭环;
- RAG 离线知识、在线回答与控制面;
- RAG 失败回溯树;
- outcome 关系;
- 不可信内容到外部副作用的信任边界;
- 多 Agent 任务与状态所有权;
- 发布门禁、Canary、回滚与事故响应状态机;
- MCP 生命周期、环境型 Agent 合同,以及实时会话/打断的补充图。
本轮新增 Mermaid 后,含 Mermaid 的文件从 15 增至 27;增加的 12 个文件均服务于主线或新增课程,不追求每页有图。
真实评测图
Agent 评测看板 已实际嵌入 3300×2220 PNG,并保留:
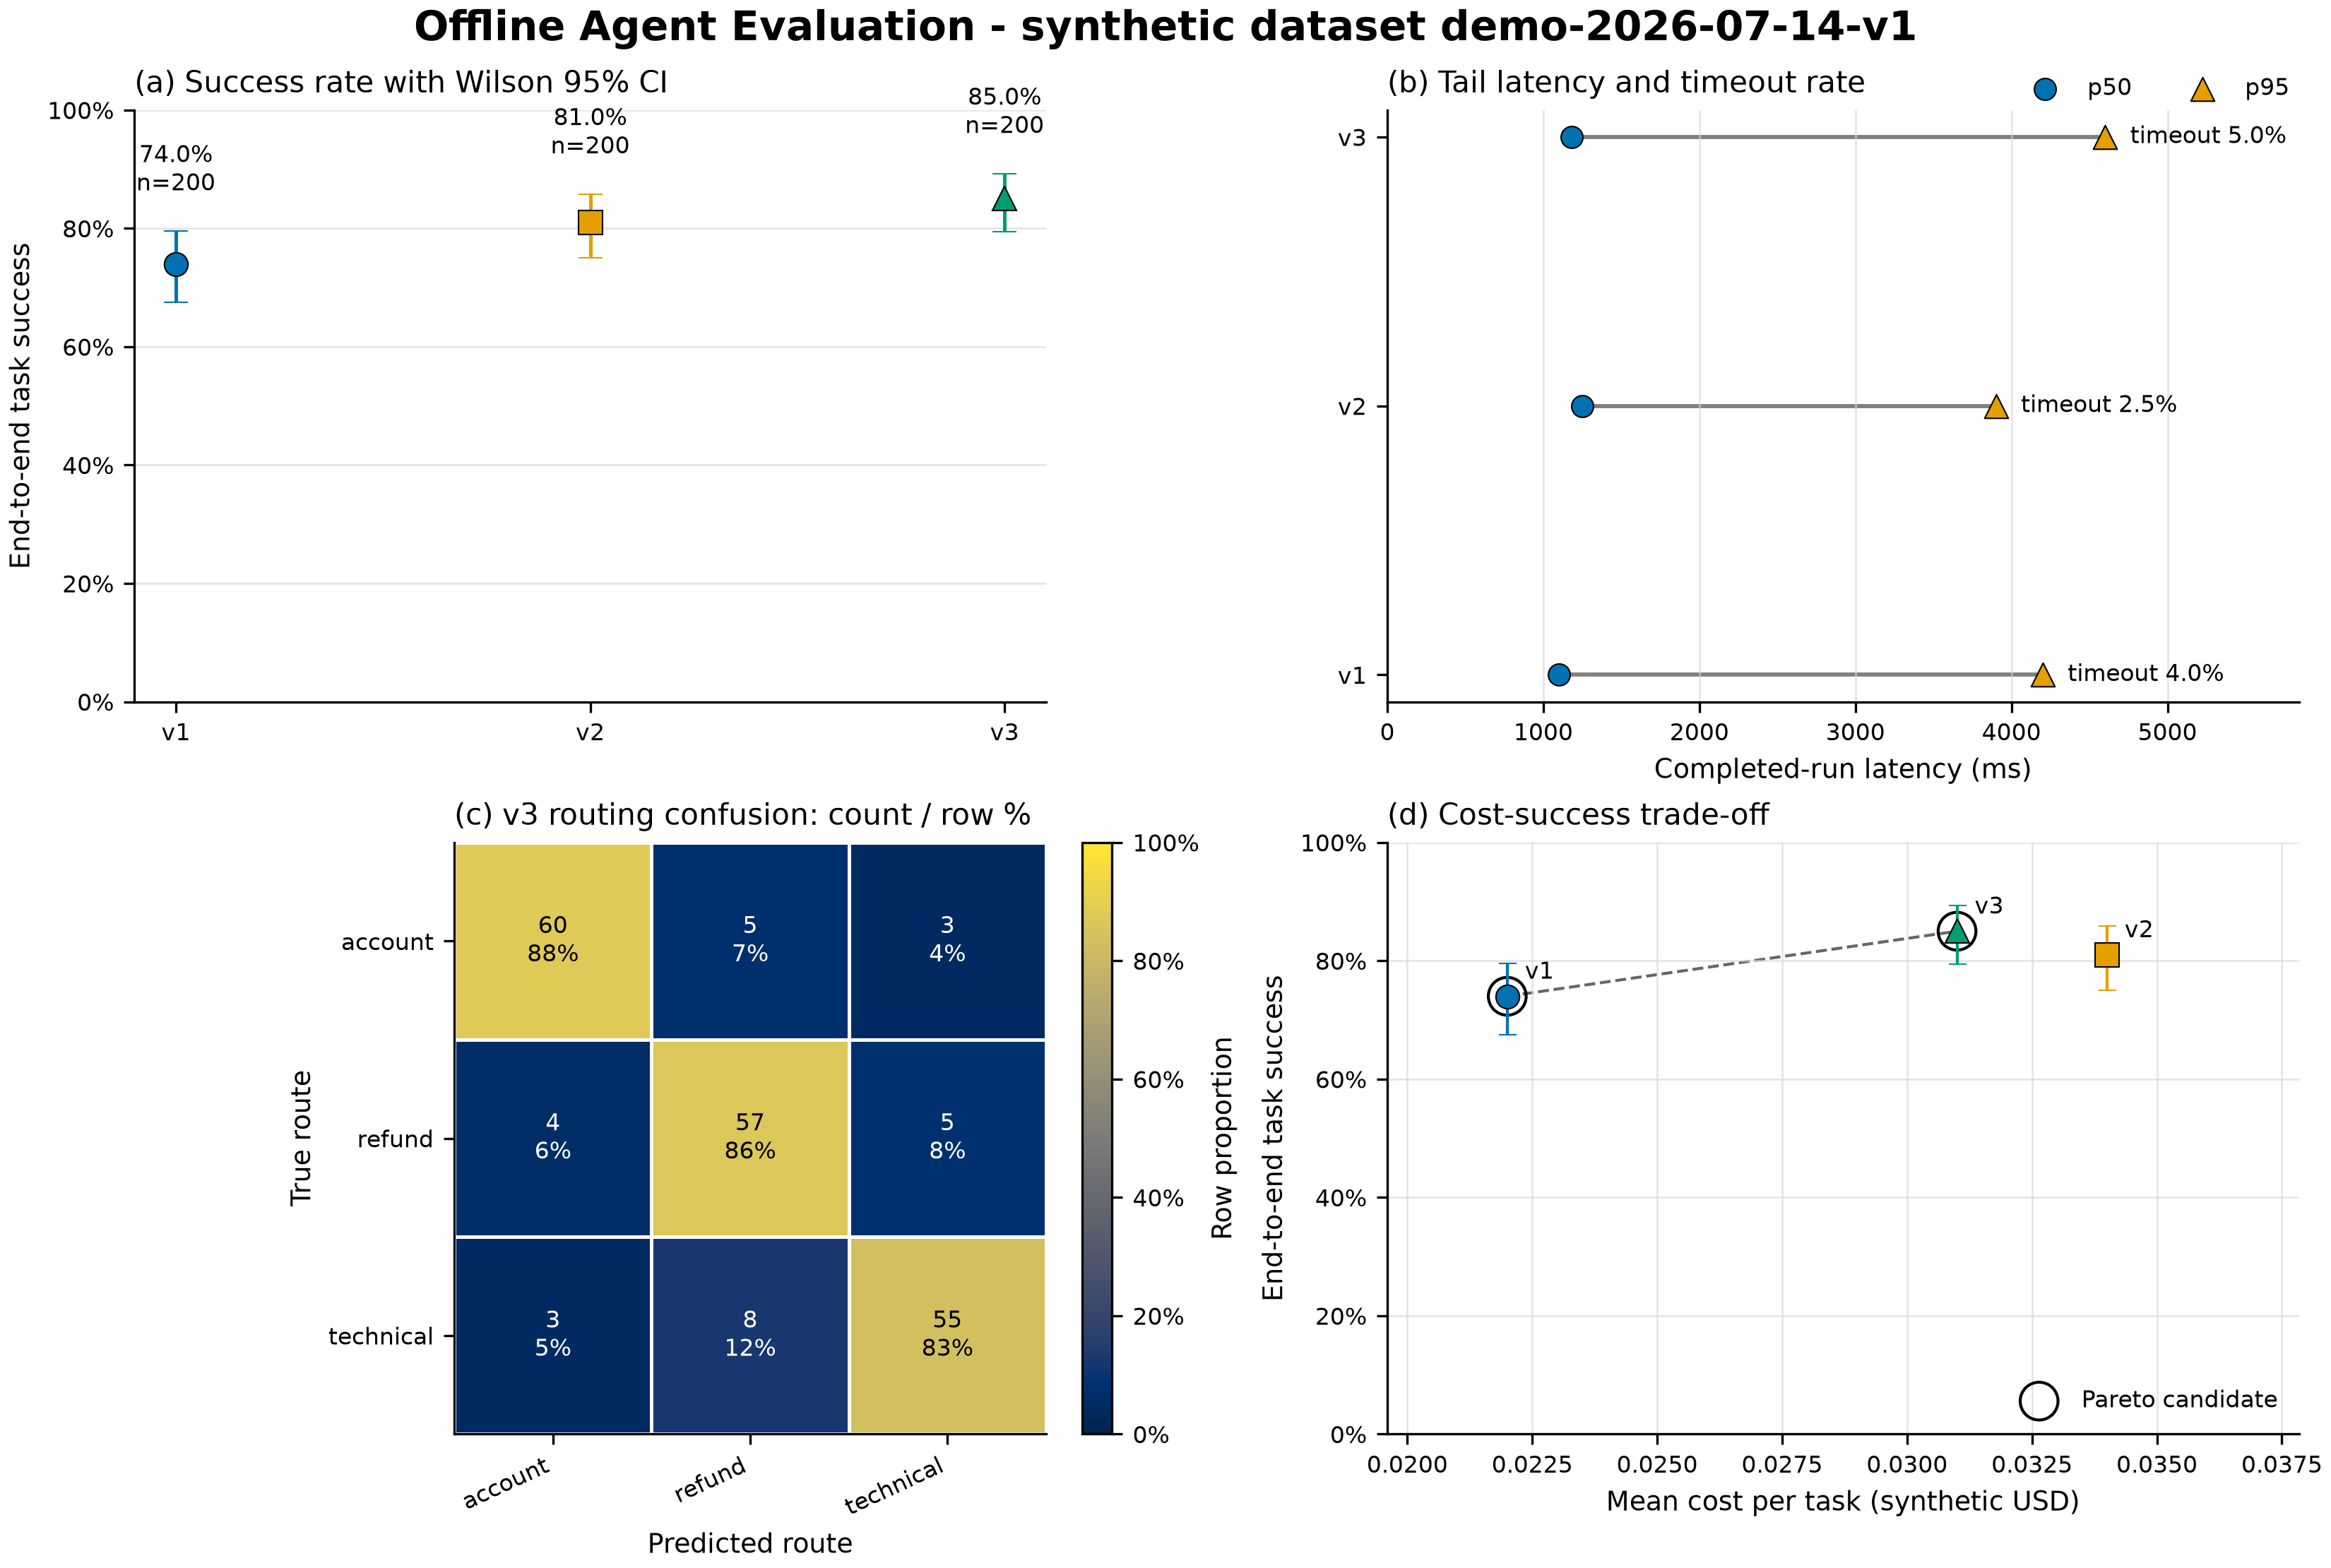
- 严格虚构聚合数据、生成脚本和锁定依赖;
- Wilson 区间、p50/p95 与超时、路由混淆矩阵、成本—成功率 Pareto 四个面板;
- 文字替代说明;
- 图注中的来源、生成环境、再生成入口与许可边界;
- 测试对尺寸、PNG/SVG、统计量、严格输入和 CLI 的检查。
图片是原创教学产物,但仓库尚未声明统一外部再分发许可证;本轮没有擅自补写许可。是否采用明确开放许可证列入人工决策。
网站课程发现与导航动态化
.website/ 的实现已从固定 53 门、8 阶段、连续整数 1..53 改为:
- 从顶层
<课程>/00-目录.md动态发现课程; - 要求 stage 非空、order 为有限且唯一的数,允许
18.5、32.5、51.5等插入顺序; - 首页、课程导航和验证器从当前 manifest/元数据计算课程数与阶段数;
- 课程地图只替换唯一指定的 Dataview view;
维护记录/作为明确 supplemental 发布范围,不被误判为课程;- 静态预览路由不再把
04-02.3-线性代数一类课程编号中的点号误判为文件扩展名;精确资源仍优先,随后统一尝试 Quartz 的.html与目录入口; - 单元测试覆盖小数顺序、缺失/非法/重复 order、动态路线、唯一 Dataview 约束和含点号的 extensionless 课程路由。
这些实现已进入最终网站构建与浏览器验收;实际结果见文末“最终验证”。
发布渲染兼容修复
构建与公开 HTML 审计把既有 KaTeX 问题定位到具体 math span,而不是据警告关键词批量改写:
- 链式法则与反向传播 的三个跨行 display-math 定界符会让后续正文进入
katex-error,改为同义单行 display-math; - 深度学习参考层的一处中文类别集合改用
\text{},一处 Unicode prime 改为 LaTeX ASCII prime。 - 深度学习参考层另外 6 个文件只含全角数学标点、数学模式内的连接词或句号;分别改为 ASCII 数学符号,或把普通中文移回 math span 外。
- 重建产物进一步暴露 34 个 D2L 参考页中的 70 个真实
span.katex-error,根因全部是split环境被放在 inline math 中。逐块把公式改为独立 display math,保留 70/70 编号与永久链接、公式正文和唯一的列表缩进;没有借此重写历史教程语义。
网站验证器新增针对真实 span.katex-error 的永久门禁,并用单测排除“正文只是提到该字符串”的假阳性。最终构建不再出现这些 warning,公开 HTML 的 katexErrors 为 0;逐公式检查确认 70/70 permalink 后均为 katex-display。
弱机器学习页面降级
content_tier: reference;content_status: needs-review;audit_checked: 2026-07-18;- 尚未完成公式、变体、框架行为和经验参数来源核验的警告。
机器学习目录 明确这两页不属于当前掌握标准。这样既不让弱证据继续占据主线,也不在缺少逐项核验时做大范围重写。
保留而未机械改写的内容
- Python 100 天历史教程、深度学习完整教程、Agentic Design Patterns 和 LangChain 导入/整理层;
- 课程中质量较高、已具备目标—前置—实践—掌握标准的主体文字;
- 既有图片、附件和相对路径,没有为统一命名而批量移动;
- 未经本轮深读的公式、框架参数和历史 API 页面;
- 各课程已有测试与 fixture,没有为增加测试数量而机械复制模板。
原因是批量格式化、统一措辞或全库替换无法提升事实质量,反而可能改变研究/教学语义、破坏链接并掩盖证据差异。后续内容维护应继续按课程、失败模式和来源逐项处理。
待人工判断与后续阶段
- 历史参考层的归宿:Python、深度学习、Agentic Design Patterns、LangChain 是继续保留、迁入独立归档,还是删除;决定前需统计反向链接、实际使用和替代页面。
- Python 历史断链:约 103 个相对链接和 3 个 stub 过渡问题是修复、保持私有,还是随归档一起处理;不应把全库自动改链直接应用到冻结镜像。
- 第三方图片与文本许可:534 个基线图片集中在导入/历史层,需要逐来源判断公开再分发范围;没有证据时继续 stub 比擅自发布安全。
- 原创评测图许可:是否给课程原创 PNG、fixture 和示例代码选择明确许可证;本轮只记录当前边界。
- 课程级元数据:是否将
content_tier、difficulty、estimated_hours、content_status设为所有课程的必填字段;若采用,应逐课评审,不批量猜值。 - 前沿转稳定门槛:MCP Apps/Tasks extension、AG-UI 和近期 benchmark 何时进入稳定主线;至少需要已发布版本、目标实现支持、互操作/负向测试和真实采用证据。
- 治理与隐私适用性:地区法规、录音同意、数据驻留、跨境和模型合同由法务/安全/隐私负责人判断,课程只提供工程证据结构。
- Obsidian 与可访问性人工验收:需在实际 Reading View/公开页面抽查 Mermaid、PNG、替代文本、灰度、移动端和 wikilink 跳转。
- 角色路径取舍:四条路径是当前证据下的默认入口;团队可根据岗位和项目增加组织内路径,但不应重新制造“所有人必学全部”的单线清单。
- 删除/重命名授权:若未来物理删除或重组课程,应作为独立批次,先产出链接、重定向、许可和恢复计划,并取得维护者确认。
最终验证
验证结论
本节在全部并行修改落盘、缓存清理和根代理独立复验后填写。它只证明本轮修改及公开发布门禁,不把未逐句核验的历史层或真实生产环境能力冒充为已验证。
最终清点
| 对象 | 交付状态 |
|---|---|
| 课程入口 / 教学阶段 | 56 / 8 |
| Markdown / Python | 872 / 178 |
文件名含 test 的 Python | 64 |
| 图片资产 | 535 |
| 含 Mermaid 的 Markdown | 27 |
| 非法课程元数据 / 重复顺序 | 0 / 0 |
实际执行结果
- Python 3.11.9:本轮新增/修改的 4 个相邻套件每种模式共 159 项——模型选择 20、环境型 Agent 103、实时多模态 24、评测看板 12。普通
python -B -W error与python -B -O -W error各运行一次,均为 159/159 通过;评测图套件使用隔离环境中的 Matplotlib 3.11.0。这里是 159 个测试在两种解释器模式下的复验,不声称全库 178 个 Python 文件均被执行。 - 环境运行时攻击复审:初次 84 项绿灯后,独立复审先后复现跨环境 pending、checkpoint rollback、receipt 漂移、审批 replay、墙钟 expiry、本地 cache 掩盖 adapter receipt 和同版本旁路状态漂移等盲区;逐项补成 RED 后再实现,最终 103 项套件与同一复现均通过。同步内存 adapter 的 receipt 不含 approval fingerprint/可信 commit timestamp,已明确降为教学信任边界;真实异步 adapter 仍需 adapter 侧 expiry、receipt 绑定和缺证据时人工 review。
- 链接与结构:新增课程、总路线与本记录共抽取 153 个 wikilink,0 个未解析;3 个显式标题锚点存在。公开构建另对全部 staged 页面执行本地链接校验。
- 网站单元测试:Node.js 24.11.0、npm 11.6.1,
npm test为 24/24 通过,覆盖动态课程发现、小数顺序、非法/重复元数据、唯一 Dataview 替换、公开路径、敏感文件、预览路由和 KaTeX 错误门禁。 - 最终网站构建:
npm run build处理 872 篇源 Markdown,得到 715 篇全文、157 篇 stub、3 个生成页和 198 个公开资源,共 staged 875 页;验证器报告 56 个课程入口、8 个阶段、0 broken local links、0 forbidden files、0 progress metadata leaks、0 sensitive leaks、0 self redirects、0 table-wikilink leaks、0 interactive checkbox leaks、0 KaTeX render errors。清理后 manifest 的excludedFiles为 650,不含 Python cache;最终构建无 KaTeX warning。 - 浏览器验收:本地静态预览经 Playwright CLI 检查首页标题、56/8 动态计数、三门新增课程入口与课程页;评测看板 PNG 完整加载为 3300×2220,
alt非空,页面控制台 0 error / 0 warning;另抽查主线 Mermaid 已生成可见 SVG,微积分与代表性 D2L 修复页不含katex-error。 - 工作区与产物:项目范围
git diff --check通过;docs/下 0 个__pycache__、0 个.pyc;未发现新增凭据、机器绝对路径或异常大生成物。未修改或纳入 vault 外既有Remarks、PRISM、Obsidian workspace 状态和网站项目说明.md的用户改动。
未由自动验证替代的人工判断
公开 Quartz 页面已做浏览器验收,但没有在本轮自动操控 Obsidian Reading View;仍建议维护者在实际主题、移动端和灰度场景抽查 Mermaid、PNG、替代文本与 wikilink 跳转。历史参考层约 103 个相对断链、第三方许可、原创评测图许可证、课程级元数据是否升级为必填,以及前沿协议何时转稳定,仍按上一节的人工决策项处理。
2026-07-22 定向维护续报
本节是对 2026-07-18 结构审计的增量记录,不回写当日的基线计数或把历史参考层误称为已逐句复核。
本次处理的具体问题
- 表格与阅读视图:Markdown 表格会把
[[目标|别名]]中的竖线当成列分隔符。已逐个修复源文档表格中的该写法,统一为[[目标\|别名]];课程地图生成器也输出转义形式,并增加全库回归测试,避免下次生成覆盖修复。All of AI另加了页面专用 Obsidian CSS class;对应 snippet 只影响该路线页面的表格宽度、折行与窄屏横向滚动。 - 示例可读性与可执行性:对原创或本地整理的 Agent、MCP、Tool Calling、RAG、检索、API、工作流、实时交互、评测与生产化教学块做了上下文式中文行尾注释;严格 JSON、JSON-RPC 转录、Mermaid、预期输出和冻结第三方材料不强行插入注释,以保留可复制性与来源边界。
- 真实语义修正:ANN Recall 与业务 Recall 现在在 ACL/filter 后以可访问集合计算;当可访问候选为空时记录
empty_eligible/不适用,不把正确的安全拒绝计为 0 分。跨语言缓存键不再把 Pythonsort_keys=True描述为通用 canonical JSON;跨实现应冻结字节协议或采用可验证的 RFC 8785 实现。OpenAI Responses 教学示例新增工具回合上限、JSON-object 参数边界、文件索引轮询的单调时钟、超时和受控重试说明。LLMOps 进一步说明人工评审与发布前后曲线各自不能单独证明什么。
证据与验证
- 表格解析审计覆盖 924 份 Markdown、707 张 GFM 表格和 5,278 个表格行:未发现未转义的 wikilink alias pipe、列数不一致或原始 inline-code pipe;课程地图的 10 张表也全部通过行宽检查。
- 全库 412 个
powershellfenced block 经 PowerShell parser 解析,0 个语法错误;期间修复了 7 处会使续行反引号失效的行尾注释和 1 个非合法占位符命令。 .website的npm test为 50/50 通过;最终npm run build处理 924 份源 Markdown,产生 927 份 staged Markdown,未报告发布门禁或本地链接错误。构建产物未纳入版本控制。- 相关离线测试由课程邻近套件复跑:协议/API 范围 533 项、生产化范围 485 项;检索、Agent runtime、工作流、实时交互、A2A 等其余受影响范围也按普通、优化和 warnings-as-errors 模式完成专项验证。测试范围证明教学合同与示例的当前行为,不替代真实供应商、浏览器、桌面、云服务或生产环境验收。
本轮一手资料与边界
- 协议与 API: MCP 2025-11-25 Specification、A2A 1.0.0 Specification、OpenAI Responses API、OpenAI Function Calling。
- 检索与序列化: RFC 8785 JSON Canonicalization Scheme、OpenAI Embeddings、Qdrant documentation。
- 评测、安全与生产: NIST AI RMF、OWASP Top 10 for Agentic Applications 2026、OpenTelemetry GenAI semantic conventions。
本次只把已由上述一手资料或本地测试支撑的结论写入主线。历史教程、冻结参考页、无法复现的供应商行为、法务适用性和尚未验证的真实生产数据继续保留原有状态或 needs-review 边界,未因“全库优化”而机械重写。